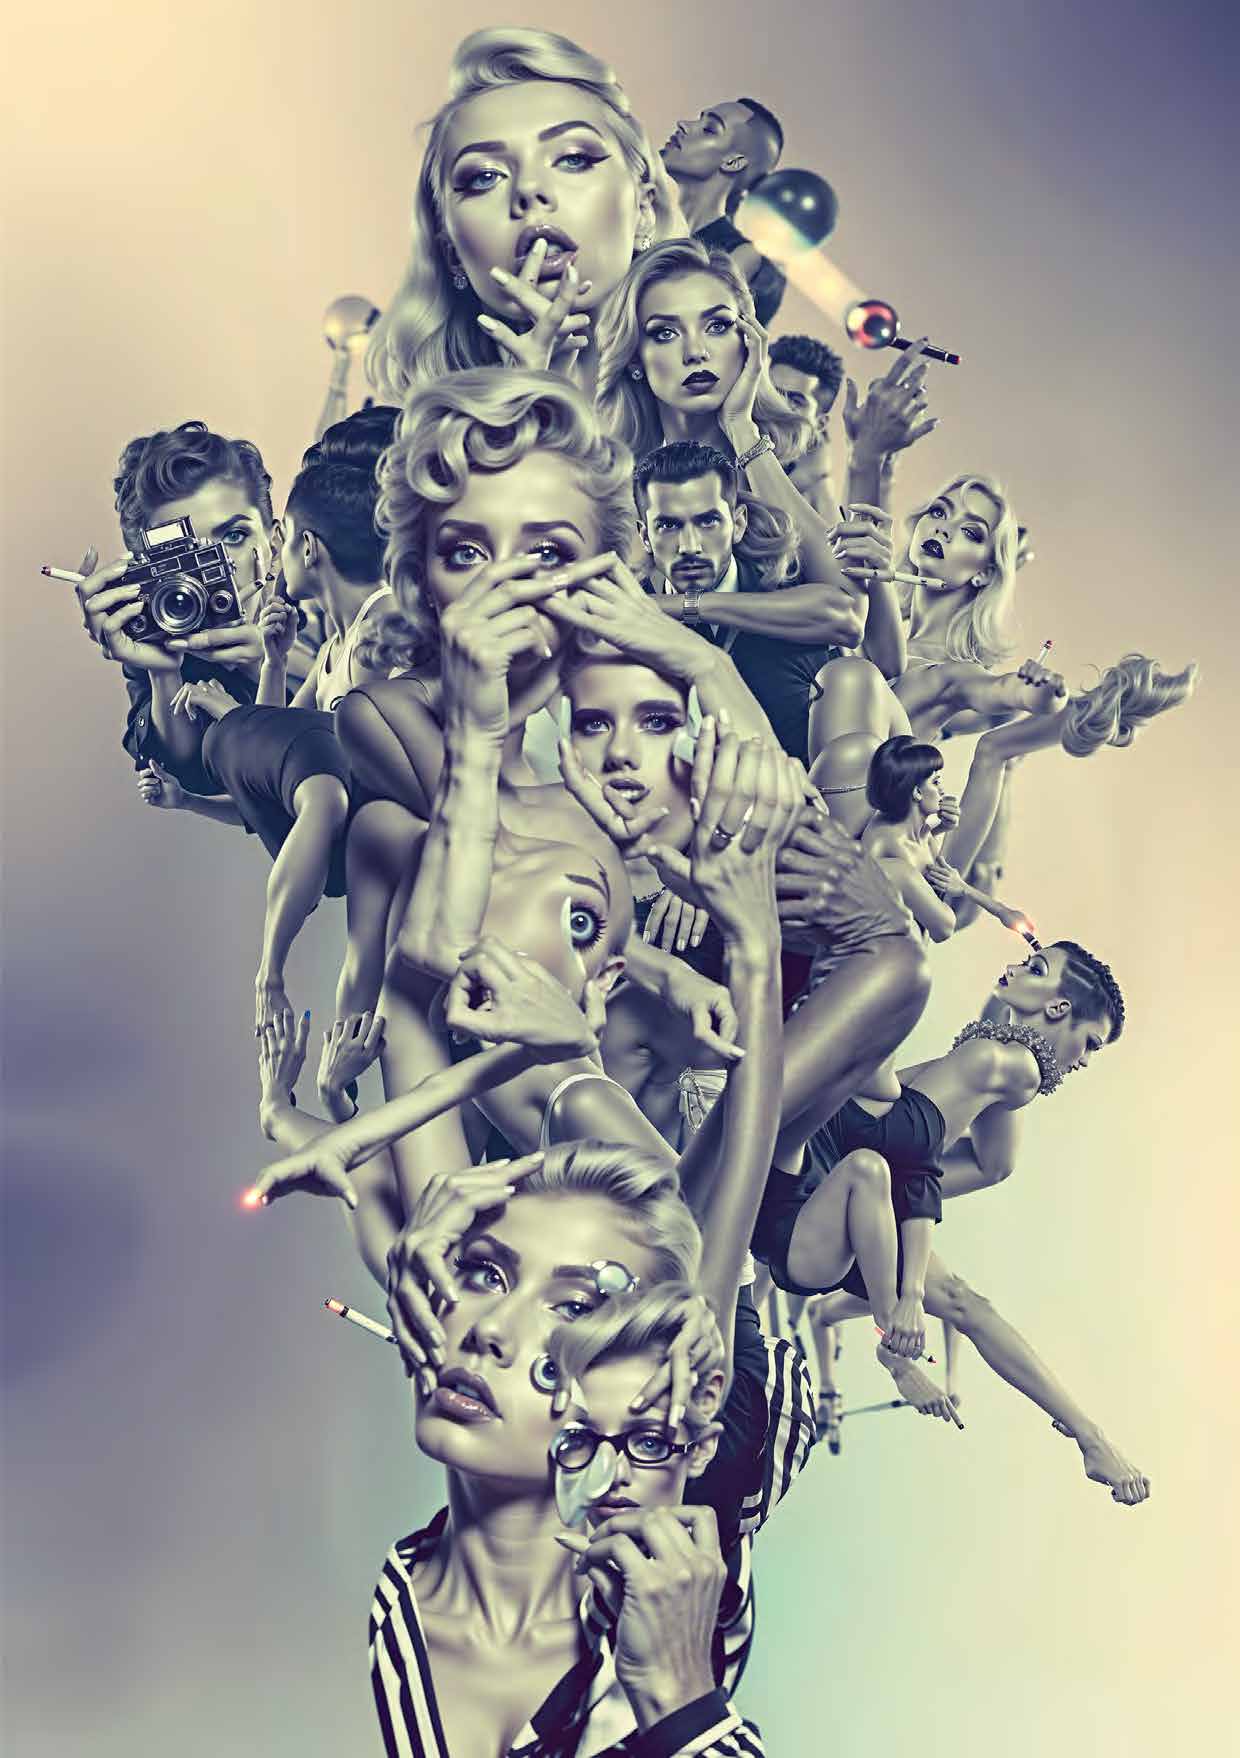
Je vais être honnête, j’attends ce moment depuis que je suis petit.
J’ai toujours rêvé d’avoir des machines intelligentes qui me pousseraient à développer d’autres formes de réflexion et me donneraient d’autres moyens de création. Je suis un fan de Star Wars. Ma vie a changé quand je suis allé le voir fin octobre 1977. C’était évident que mon futur serait technologique. Juste après avoir passé mon adolescence à découvrir l’informatique avec les premiers ordinateurs domestiques (le PET de Commodore, l’Atari 400, l’Apple IIe), Philip K. Dick me retournait la tête dans ma vingtaine. La vie non-organique… L’intelligence artificielle douée de sentiments. C’était ça mon kiff. Alors effectivement, il aura fallu attendre des années avant que l’IA nous soit accessible et que l’approche soit « friendly ».
En 2016, je jouais de loin avec les GANs, les transferts de style, mais je n’avais pas la main sur la machine, je ne savais pas comment utiliser un PC car j’étais sur Mac et encore moins entrer des lignes de codes pour faire tourner ces outils. Je ponçais régulièrement le cerveau de mon pote Eric (Eric Debeir, tribune dans ce numéro - NDLR) pour qu’il le fasse pour moi… C’est le 5 septembre 2022 très très tôt le matin que tout bascule. En scrollant comme un mouton sur mon Instagram, je tombe sur une image dingue avec comme hashtag #discodiffusion… je cherche, fouille ce réseau de malheur pour comprendre de quoi on parle, et tombe sur #StableDiffusion. Mais de quoi on parle ??
En ouvrant Dream Studio (qui venait d’être mis sur le marché la semaine précédente par Stability AI) j’ai tout de suite su que j’allais switcher vers cette technologie. On parle donc de produire des images en écrivant l’idée… Brillant ! Je me mets donc à produire des milliers d’images, pour comprendre le fonctionnement du Text2Img, le prompting, la clé du futur. Écrire des mots pour produire des images et du son, et bientôt pour toutes les tâches qui passeront par une interface informatique.
L’IA met d’un coup en lumière deux choses très importantes : une nouvelle forme de créativité sans limite et une communication ancestrale par les mots.
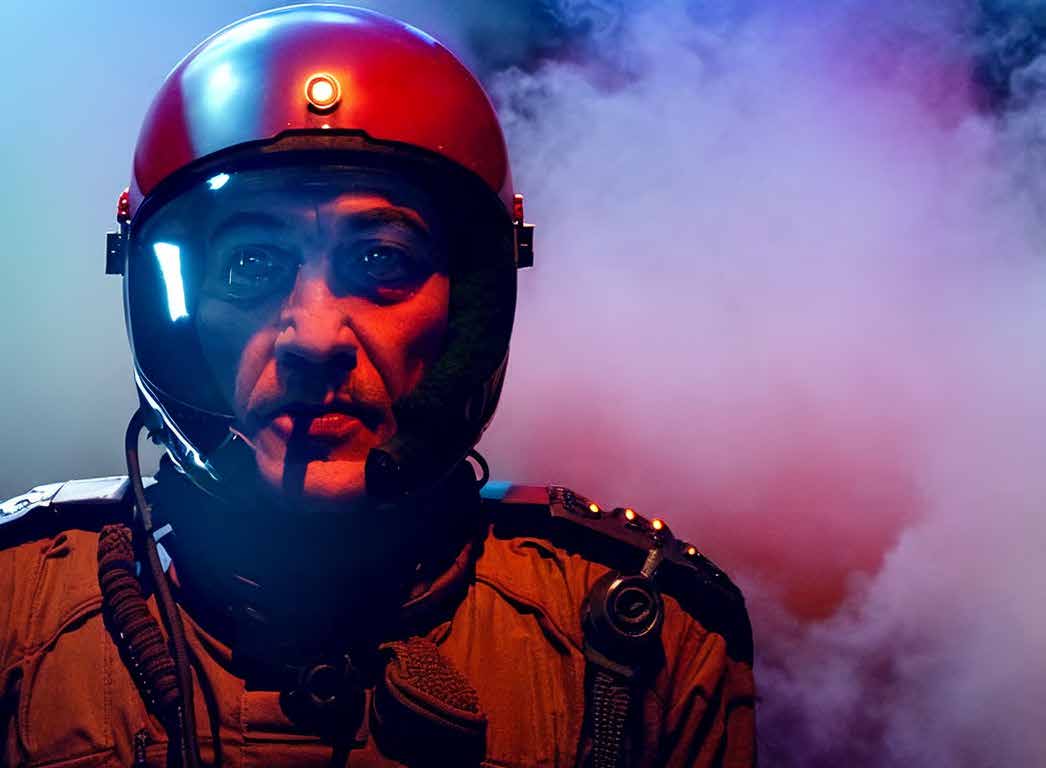
J’ai ensuite mieux compris le fonctionnement de cette interface et me suis concentré sur ce qui me plaisait le plus, l’animation. Mes premiers tests consistaient à prendre quelques secondes d’une vidéo que je venais de tourner, la transformer en suite d’images, les passer dans Dream Studio une à une pour ensuite les remettre dans mon logiciel d’édition et en faire une vidéo entièrement réinterprétée par Stable Diffusion… procédé hyper long mais satisfaisant, bien que la consistance ne soit pas au rendez-vous. Les images étaient toutes un peu différentes, créant une vibration permanente à la limite du soutenable. Mais un groupe de petits génies venait de développer Deforum, un logiciel d’animation utilisant Stable Diffusion et qui tournait sur un Jupyter Notebook dans un Google Colab… tant de nouvelles choses à découvrir, mais surtout tellement de choses à apprendre. Avant de faire tourner Deforum, j’ai dû apprendre cet univers de geek, ces pages de scripts, ce langage codé bien ouf pour un novice mais tellement excitant. Token, Seed, Transformer, Tensors, ces mots ne sonnaient aucune cloche dans mon esprit. Après quelques semaines de peine et de désillusion, je sors enfin ma première vidéo, et je suis absolument sidéré par le résultat.
Deforum fonctionne en Text2Img avec des suites de prompts attachés à des keyframes. Ce qui veut dire que la vidéo évolue et peut suivre les idées qu’on place à des moments précis… le cinéma génératif fait son apparition. Quelques téraoctets de vidéos furent générés, des centaines d’heures de crédits Google dépensées avant de mettre ça à profit. À ce moment-là, je m’occupais de la musique de la série « Besoin d’amour » (OCS) de Fred Hazan. Il cherchait quelqu’un pour faire le générique. Je prends 2 jours de réflexion, et je lui propose alors de le faire avec mes nouveaux outils. Un package musique et animation via Deforum. Tout le monde a adhéré au résultat et je mettais un pied dans la réalisation. J’enchaîne alors sur un clip pour mon frère BoomBass et un clip pour « La Plage/Captain ».
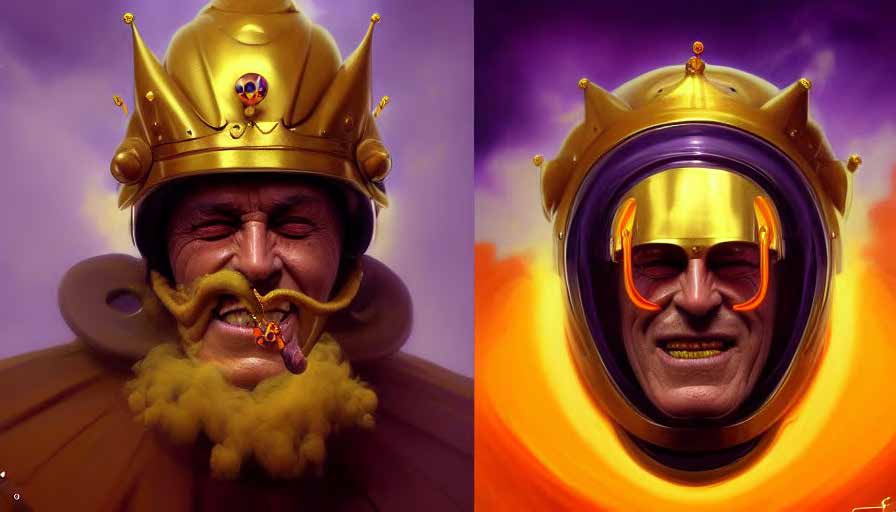
J’ai ensuite approfondi les techniques d’animation, et les améliorations de plus en plus rapides. L’arrivée de ControlNet a changé la donne. ControlNet permet de saisir une référence dans la dernière image générée et de l’appliquer à la prochaine, garantissant une meilleure consistance… mais ce n’était que le début d’une évolution non-stop et épuisante. ControlNet, SDXL, Animatediff, IPAdapter… et j’en passe, seront les game changers dans l’animation AI.
Depuis presque un an, je travaille sur un logiciel en open source appelé ComfyUI, installé sur ma machine en Linux, ça aussi c’était un autre challenge : apprendre à communiquer en Python via un terminal, créer des venv, plonger dans l’univers GitHub et Hugging Face et découvrir cette incroyable communauté de l’open source. ComfyUI est un logiciel nodal qui permet de faire presque tout ce qui est possible avec Stable Diffusion, et même d’autres choses vraiment dingues comme intégrer un LLM (modèle de langage de type GPT) au moment du prompting, ou alors pour analyser une image qu’on met en entrée et en tirer une description hyper détaillée. C’est avec ComfyUI que j’ai fait les clips de l’album « So Sorry » en utilisant Animatediff, un autre procédé qui est entraîné sur des vidéos en mouvement.
Mais avant de pouvoir faire ces clips, il aura fallu apprendre à entraîner un modèle avec ma tronche… genre d’usine à gaz au moment où je m’y suis mis. Cela consiste à « fine-tuner » un modèle de base, SDXL dans mon cas, en créant un Lora. Le Lora est une version légère du modèle qui s’ajoute au modèle comme un plugin lors du process. On nourrit le modèle avec un dataset, ici une collection d’images de moi et une description détaillée de ce qu’on voit sur la photo. Ensuite, c’est une longue expérimentation avant d’avoir un modèle satisfaisant, et surtout un temps de calcul assez pénible quand on n’a qu’une carte vidéo grand public.
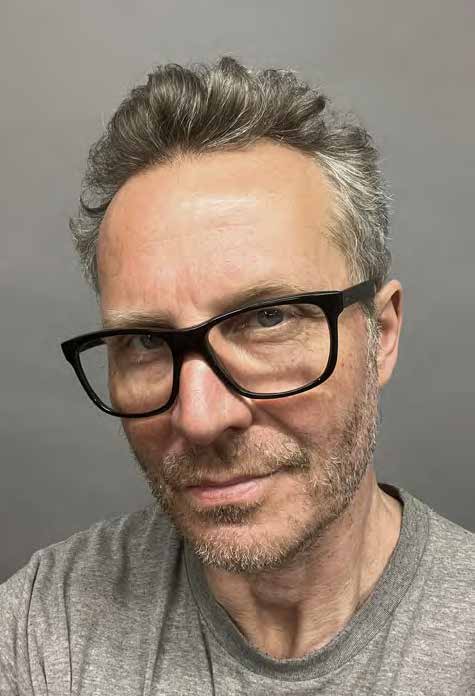
Pour « So Sorry », l’idée était de me voir plus jeune et plus grisonnant au milieu d’un monde en décomposition et d’avoir cette double identité homme-femme, chose à laquelle je tenais car avec tous ces débats sur l’identité sexuelle et le genre, j’avais envie de dire que pour ma part, j’étais un savant mélange de tout. C’est assez fou ce que ce workflow m’a permis de faire, et j’en suis assez fier car c’est parfois assez difficile d’obtenir ce qu’on désire. Car même si il y a une énorme part de travail qui est effectué par le logiciel, la partie recherche est assez longue et parfois déroutante. Il faut choisir et savoir où on va, sinon on passe des journées entières à tester des rendus tous aussi différents et souvent tous aussi hallucinants, une abondante source de possibilités qui fait perdre la tête. Pour « Irrational Interlude », je voulais un trip un peu sous acide. La multiplication du moi Sinclair prend toute la place et les autres moi sont étranges… un ego trip non narcissique.
Je réalise des mini films, des clips et des objets visuels depuis longtemps, et je me suis monté un mini studio vidéo pour expérimenter tout ça. C’est mon fantasme d’enfant, avoir un studio comme ILM de George Lucas… bon, alors on n’y est pas, mais le chemin est emprunté.
En cherchant tout ce qui se faisait en matière d’IA, j’ai évidemment joué avec les premiers Text2music qui donnaient des résultats vraiment dingues. MusicGen et Audiocraft sont pour moi très expérimentaux mais passionnants. Tout est dans le prompt, mais pas que, car il y a cette fonction démente de music2music où il suffit d’entrer une suite harmonique, une mélodie ou un sample et de le transformer par le prompt… pareil, sans limite donc assez fou à gérer.
Grâce à ce processus, j’ai fait la musique d’un film de 15 minutes pour l’exposition de Robin Lopvet au centre d’art et de photographie de Lectoure. Le film est sur l’histoire de la photographie new-yorkaise revue à travers l’IA. Robin travaille essentiellement ses photos sur Midjourney en les faisant réinterpréter. On a ensuite upscalé les rendus dans Stable Diffusion et animé une partie dans Gen2, le reste étant une technique d’animation qui est propre à Robin. Je me suis dit que la musique devait être en partie générée en AI comme les images. J’ai donc utilisé des parties de titres que j’avais en stock et d’autres que j’avais fabriquées, et les ai modifiées avec MusicGen, un processus assez long mais vraiment trippant. Parfois, le même morceau original donne 3 versions absolument distinctes. On a fait une version de 4 minutes de ce film et il sera diffusé pour les rencontres de la Photo à Arles le 6 juillet.
Ce qui me passionne, c’est de chercher. Depuis toujours, je cherche et pousse mes projets aux frontières de mes compétences. C’est ici que je m’amuse, ce bord de scène avec un pied dans le vide. Je passe une heure chaque matin à lire des forums, des salons Discord ou des communautés Reddit pour connaître les dernières avancées de l’IA sous toutes ses formes. Je guette le moment où nous pourrons utiliser « Sora » d’OpenAI, ce modèle qui fait trembler les agences de pub et Hollywood, mais qui à mon avis nécessite cinq bâtiments remplis de cartes Nvidia H200 pour le faire tourner… Je m’intéresse de très près à Udio, qui est pour moi la révolution musicale en marche. Cet outil va transformer la musique commerciale, la distribution et le droit d’auteur… et va mettre une quantité d’artistes auteurs compositeurs en galère. J’utilise aussi LLMstudio, pour essayer des modèles de langage quantifiés, car c’est un peu le point de départ, le langage en IA. Je pense que nous sommes à un moment identique à celui où l’internet est arrivé dans nos foyers.
Nous sommes en pleine révolution technologique, avec des effets moins prometteurs pour la population que ne furent ceux de l’internet. Lorsque le sampler est arrivé, j’ai plongé dans la machine et réussi à produire mes premiers titres, participer à un des premiers albums de Rap français et sortir mon premier album grâce à cette nouvelle technologie.
L’intelligence artificielle est mon sampler de 2024.
Je l’intègre dans tous mes processus, et je ne parle pas de chatGPT qui est devenu essentiel à l’optimisation de mon travail en général. Pour finir, je crois que l’avenir des créateurs est de fine-tuner ses propres modèles, créer des versions uniques avec des datasets personnels, les copyrighter et les faire circuler. Le modèle économique va se mettre en place, et nous oublierons totalement les doutes actuels, comme on a oublié Napster… Mes futurs projets sont surtout dans la prod de titres des artistes avec lesquels je travaille, la réalisation de clips qui vont avec, et avancer sur un projet de petit film.
Je vais fêter le premier anniversaire de mon label « Rockette Records » que nous avons monté à Arles l’été dernier. Nous allons clôturer le festival des Escales du Cargo au théâtre antique le 21 juillet. Une grosse fiesta avec toute l’équipe du label ! Et de la projection de vidéos… en IA !